¿Qué es RAG?
Definición de RAG
RAG (del inglés Retrieval Augmented Generation o Generación Aumentada por Recuperación) es una arquitectura de IA que combina un motor de búsqueda/recuperación de información con un modelo de lenguaje (LLM).
En lugar de confiar únicamente en la memoria del entrenamiento almacenada en sus pesos, RAG busca fragmentos de datos exactos en una base de conocimiento externa y los introduce en la ventana de contexto del modelo (su memoria de trabajo) para generar una respuesta fundamentada.
🎧 Podcast: Sistemas de RAG que mejoran las respuestas de los modelos de lenguaje.
¿Cómo funciona el flujo RAG?
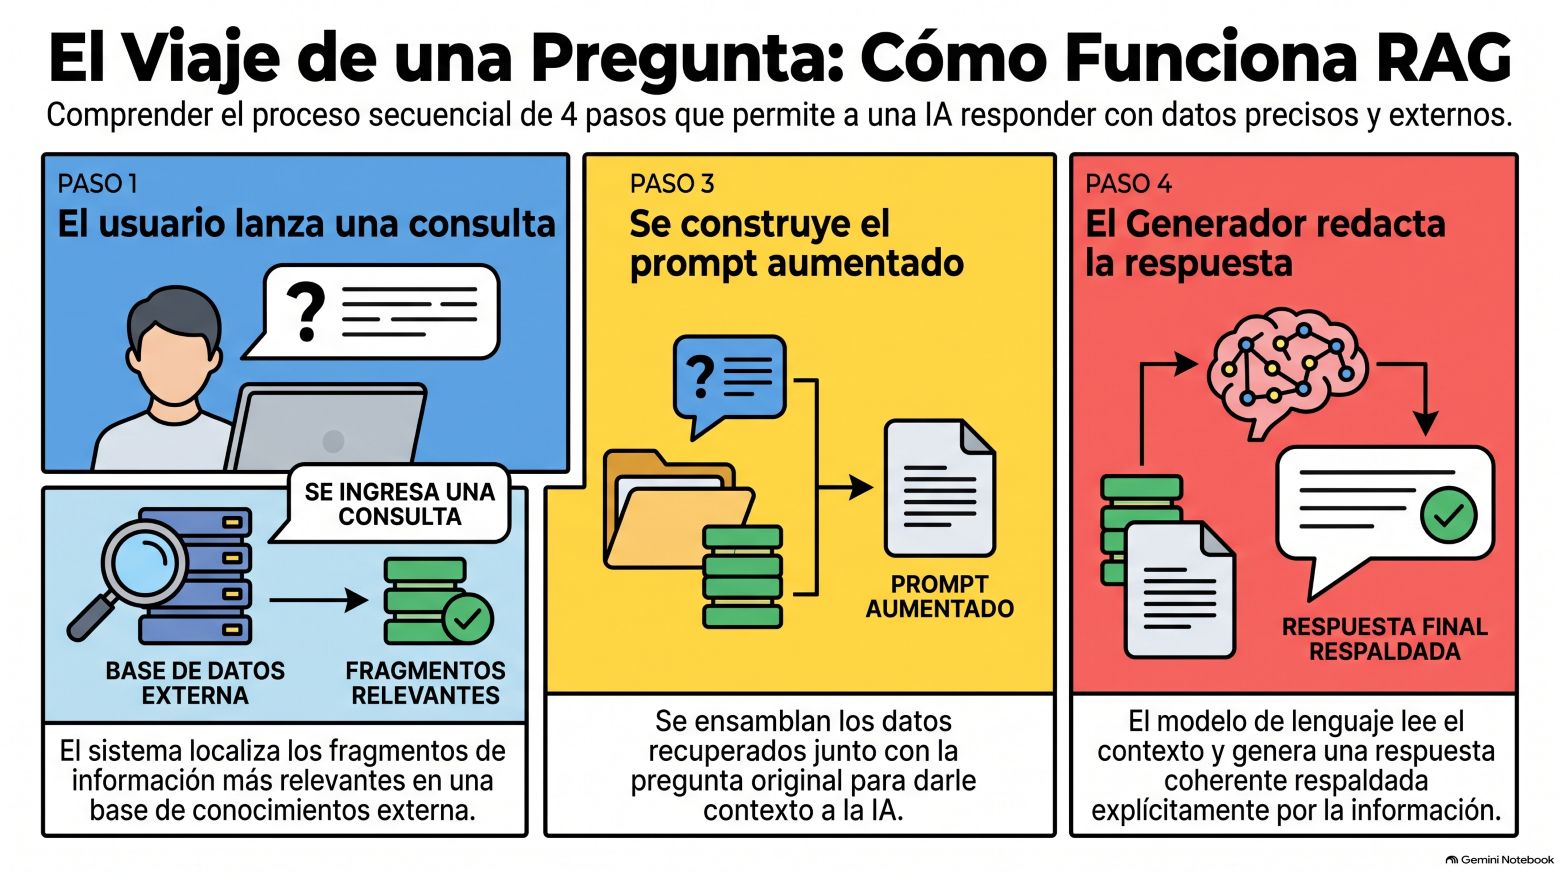
Un pipeline de RAG opera básicamente a través de cuatro pasos principales:
- 1
Consulta del usuario
El usuario ingresa una pregunta o instrucción en lenguaje natural.
- 2
Recuperación de información relevante
El sistema convierte la pregunta en un vector y busca en la base de datos externa (mediante búsqueda semántica o por palabras clave) los fragmentos de documentos más relevantes.
- 3
Construcción del prompt aumentado
Los fragmentos recuperados se ensamblan junto con la pregunta original para enriquecer el contexto enviado al modelo.
- 4
Generación de la respuesta
El LLM lee el contexto recuperado y redacta una respuesta coherente y respaldada explícitamente por esa información.
¿Para qué sirve y cuáles son sus beneficios?
- Eliminación de alucinaciones: al obligar al modelo a responder apoyándose únicamente en datos reales extraídos en el momento, se reduce drásticamente la invención de datos o respuestas fácticamente incorrectas.
- Acceso a información actualizada: permite que el asistente consulte documentos recientes o cambiantes en tiempo real sin requerir un costoso reentrenamiento del modelo.
- Uso de datos privados y empresariales: permite conectar la IA con bases de conocimiento internas (como manuales, archivos PDF, bases de datos o código) de forma segura y delimitada.
- Trazabilidad y citas de fuentes: hace posible que el sistema indique o cite la fuente exacta y el número de página/documento de donde proviene la información.
- Eficiencia en costes: resulta considerablemente más rápido y económico actualizar la base de datos externa que realizar un proceso de ajuste fino (fine-tuning) sobre los parámetros del LLM.
Arquitectura de componentes de un sistema RAG
Para implementar un sistema RAG (Retrieval Augmented Generation o Generación Aumentada por Recuperación) en producción, se requiere una arquitectura estructurada en componentes y servicios básicos distribuidos a lo largo de varias capas funcionales:
🧪 Flujo de datos en un sistema RAG
Detalles de la arquitectura
1. Capa de ingesta y procesamiento de datos (Ingestion Pipeline)
- Cargadores de documentos (Document Loaders): conectores y analizadores para extraer texto desde diversas fuentes como archivos PDF, DOCX, archivos de código, bases de datos o wikis corporativas.
- Segmentador de texto (Text Chunker): módulo encargado de dividir documentos extensos en fragmentos más pequeños (chunks) para mantener la granularidad y la coherencia semántica.
- Modelo de embeddings (Encoder): un modelo de IA especializado (ej.
all-MiniLM-L6-v2,bge-large-eno servicios vía API) que convierte cada fragmento de texto en un embedding (vector denso de números) que representa su significado.
2. Capa de almacenamiento y base de conocimiento (Knowledge Store)
- Base de datos vectorial (Vector Database): sistema de almacenamiento optimizado (ej. Pinecone, Milvus, OpenSearch, Weaviate o PGVector) para alojar los embeddings generados y permitir búsquedas de similitud geométrica a gran escala.
- Almacén de documentos y metadatos: Almacenamiento persistente (S3, base de datos relacional o sistema de archivos) para guardar el texto crudo original, números de página, marcas de tiempo y enlaces asociados a cada vector.
3. Capa de recuperación (Retriever)
- Codificador de consulta (Query Encoder): convierte la pregunta enviada por el usuario (en lenguaje natural) en un embedding (vector) utilizando el mismo modelo de embeddings de la etapa de ingesta.
- Motor de búsqueda de similitud: algoritmo que calcula la distancia (ej. similitud coseno o producto punto) entre el vector de la pregunta y la base vectorial, recuperando los \(k\) fragmentos con mayor coincidencia de significado.
- Recuperación híbrida y reordenamiento (Reranking) [Opcional]: combina la búsqueda semántica vectorial con la búsqueda por palabras clave (BM25) y pasa los resultados por un modelo de reranking para garantizar la máxima relevancia antes de construir el mensaje.
4. Capa de orquestación y generación (Generative Core)
- Constructor de prompts y gestión de contexto: ensambla la ventana de contexto adjuntando las instrucciones del sistema (System Prompt), el contexto útil recuperado y el historial de la conversación.
- Modelo de lenguaje (LLM / SLM): el motor generativo (ej. Llama 3, Claude, GPT-4 o un modelo local en vLLM/Ollama) que analiza el prompt aumentado y redacta una respuesta coherente fundamentada en los datos provistos.
- Framework o arnés de orquestación: software intermedio (ej. LangChain, LlamaIndex o un arnés a medida) que ejecuta el bucle de control, maneja errores, gestiona la memoria y coordina el flujo completo.
5. Capa de Guardarraíles, Seguridad y Observabilidad
- Filtros de seguridad (Guardrails): validan las entradas contra ataques de inyección de prompts y verifican que la salida no contenga alucinaciones ni filtre datos sensibles.
- Plataforma de observabilidad y evaluación (LLM Evals): mide de forma independiente la precisión de la etapa de búsqueda (retrieval recall) y la fidelidad de la respuesta generada (generation faithfulness).
Casos de uso de RAG
Principales casos de uso prácticos de RAG organizados por sectores y aplicaciones reales:
Gestión del conocimiento interno y empresarial
- Bases de conocimiento privadas: permitir a los empleados chatear con especificaciones de código, notas de proyectos, archivos PDF, wikis en Confluence o repositorios de GitHub sin enviar datos confidenciales a la nube.
- Atención al cliente y soporte técnico: chatbots capaces de consultar manuales de productos, estados de pedidos o políticas de devolución para dar respuestas precisas y actualizadas en tiempo real.
Sector legal, regulatorio y normativo
- Análisis de contratos y normativa: búsqueda rápida en bases de datos de jurisprudencia, normativas institucionales (como las guías WCAG) o regulaciones de privacidad (como el RGPD), citando siempre la fuente y el documento original.
- Auditoría de cumplimiento: verificación de políticas internas y cumplimiento corporativo mediante el contraste automático de documentación.
Salud y atención médica
- Consulta de literatura y protocolos clínicos: ayudar a profesionales de la salud a consultar rápidamente bases de datos de medicamentos, historias clínicas y guías de tratamiento sin comprometer la privacidad de los pacientes.
Educación e investigación académica
- Asistente de estudio e investigación: permitir a estudiantes e investigadores subir colecciones de papers, libros de texto o notas para realizar consultas conceptuales y obtener resúmenes con citas exactas respaldadas por la literatura.
Sistemas locales y dispositivos embebidos (Edge AI)
- Asistencia en automoción y movilidad: ejecución de RAG con modelos de lenguaje pequeños (SLM) en ordenadores de a bordo para consultar el manual del vehículo, códigos de avería o normas de circulación en tiempo real.
Caso práctico del flujo de trabajo RAG con agentes autónomos
Un flujo de trabajo (pipeline) completo de Atención al Cliente y Soporte Técnico basado en una arquitectura RAG (Retrieval Augmented Generation) y agentes autónomos combina un módulo de recuperación de datos con la capacidad de ejecutar acciones mediante herramientas en un ciclo controlado.
🧪 Flujo de trabajo de un sistema RAG con agentes autónomos
Detalle flujo de trabajo de un sistema RAG
1. Ingesta de Datos y Sanitización de la Entrada
- Recepción multimodal: El usuario inicia el contacto enviando un texto, una nota de voz o una captura de pantalla del error desde la app o web.
- Filtro de seguridad previo: Se sanean los datos de entrada eliminando caracteres invisibles y aplicando clasificadores para prevenir ataques de inyección de prompts antes de que el texto llegue al modelo principal.
2. Enrutamiento Inteligente de Consultas (Clasificador SLM)
- Un Modelo de Lenguaje Pequeño (SLM) evalúa la intención inicial para optimizar costes y latencia:
- Preguntas Frecuentes / Básicas: Se resuelven de forma inmediata mediante plantillas preconfiguradas o el SLM local.
- Consultas Complejas o Especializadas: Se derivan al pipeline completo de RAG y al modelo principal (LLM).
3. Recuperación de Conocimiento Externo (RAG Pipeline)
- Vectorización (Embedding): La consulta del usuario se convierte en un vector denso de coordenadas semánticas.
- Búsqueda en la Base de Datos Vectorial: El componente Retriever busca en el repositorio (manuales de productos, guías de solución de problemas, políticas de garantía) los \(k\) pasajes más relevantes mediante similitud semántica.
4. Integración con Herramientas Transaccionales (Function Calling / MCP)
- Si la consulta requiere datos personales o estado en tiempo real (ej. "¿Por qué mi módem no sincroniza?" o "¿Cuál es mi saldo actual?"):
- El agente utiliza Llamada a Funciones (Function Calling) o servidores MCP para consultar sistemas de fondo de la empresa (CRM, herramientas de diagnóstico de red o plataformas de facturación).
5. Bucle Agéntico de Razonamiento y Generación (Patrón ReAct)
- Ensamble del Prompt Aumentado: Se construye el contexto combinando el System Prompt (que define el rol empático y las reglas negativas), el contexto RAG recuperado, los datos obtenidos de las APIs y el historial de chat.
- Ciclo Razonar \(\rightarrow\) Actuar \(\rightarrow\) Observar: El modelo ejecuta el bucle ReAct, evaluando los datos de diagnóstico recibidos de la red, ajustando sus conclusiones y redactando los pasos exactos de solución técnica.
6. Guardarraíles de Salida e Intervención Humana (Human-in-the-Loop)
- Verificación Factual: Se contrasta la respuesta generada con los pasajes recuperados para garantizar un 0% de alucinaciones.
- Puntos de Control Humano: Si la solución requiere una acción irreversible (ej. aplicar un descuento significativo, cancelar un contrato o enviar un técnico a domicilio), el harness pausa el agente y solicita aprobación explícita de un operador humano antes de ejecutar la orden.
7. Entrega de Respuesta y Documentación Automática
- Se entrega al cliente una respuesta clara con instrucciones paso a paso.
- El agente genera un resumen automático de la incidencia (causa raíz, solución aplicada y nivel de satisfacción estimado) y lo registra directamente en la ficha del cliente en el CRM.